Eine Suche nach einer einzelnen Angabe in einem langen PDF stellt andere Anforderungen als die Suche nach dessen Thema. Wer nach der zulässigen Last einer bestimmten Halterung fragt, braucht die passende Stelle mitsamt Einheit und Einschränkung. Ein einziger Vektor kann ein Dokument kompakt abbilden. Viele Vektoren bewahren mehr lokale Vergleichsmöglichkeiten, brauchen dafür aber mehr Indexspeicher. Die neuen offenen Suchmodelle von Perplexity machen diesen Zielkonflikt anschaulich.
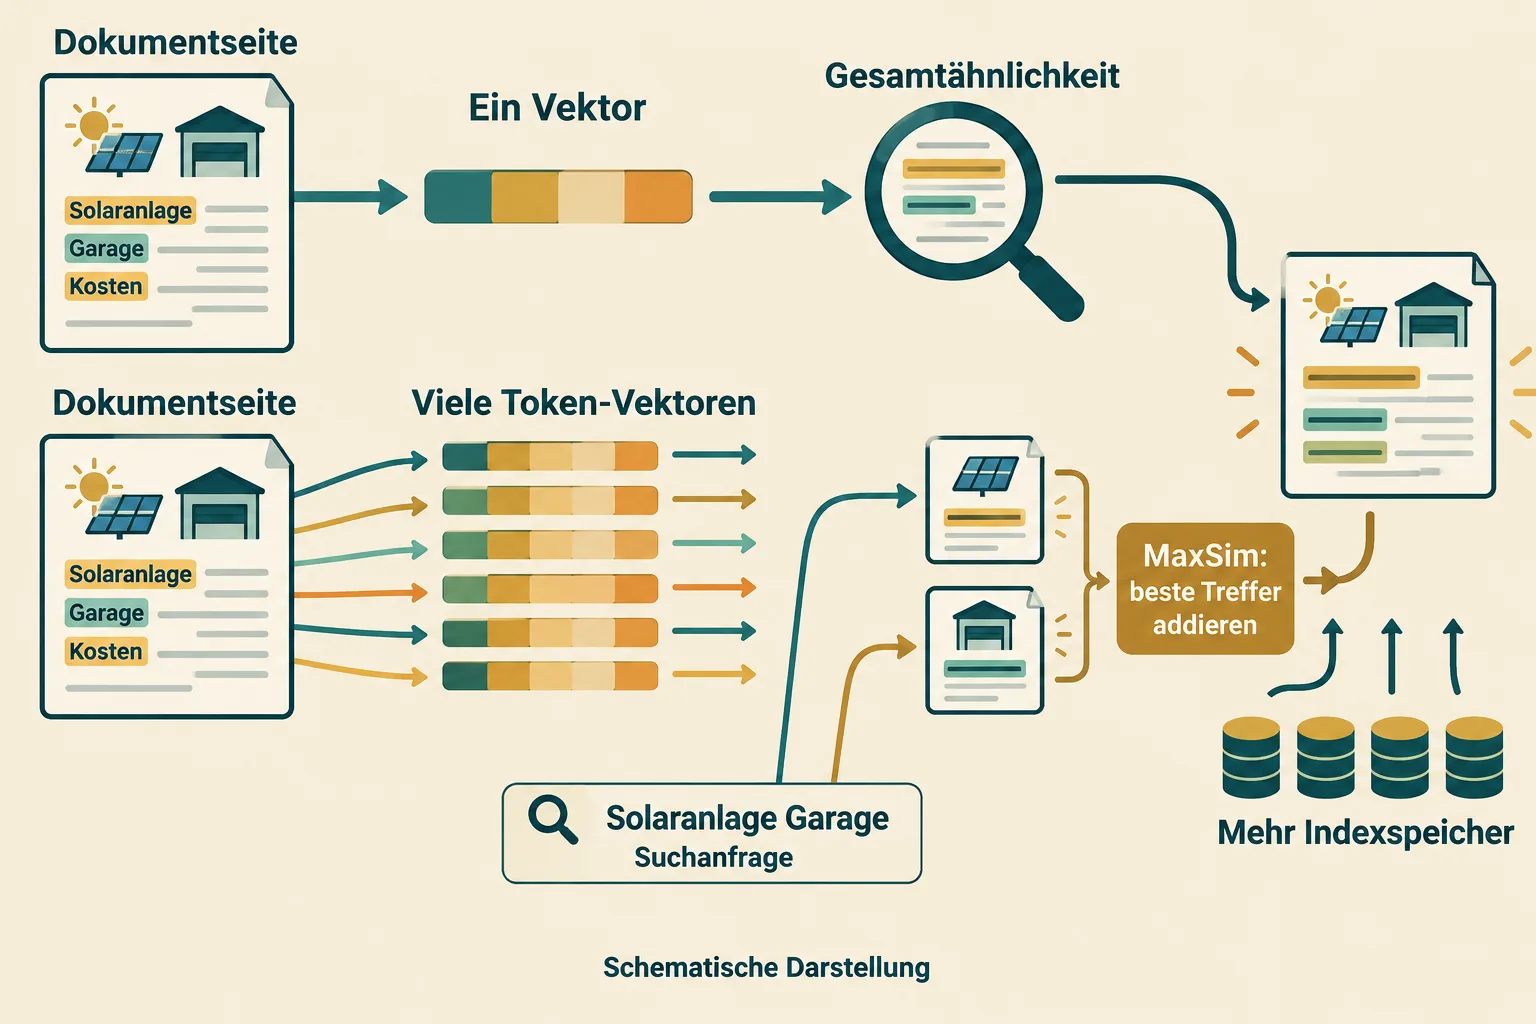
Die Modellkarte von pplx-embed-v2-late beschreibt einen Vektor mit 128 Dimensionen je Token. Die Modelle verarbeiten Text, Bilder und visuelle Dokumente. Zwei unterschiedlich große Varianten teilen sich einen Vektorraum: Ein kleineres Modell kann deshalb einen Index abfragen, der mit dem größeren erzeugt wurde. Entscheidend für die Einordnung ist die Suchmethode. Sie erhält viele einzelne Repräsentationen und führt sie erst beim Vergleich mit einer Frage zusammen.
Was bei einem einzigen Vektor verdichtet wird
Ein Embedding ist eine Zahlenfolge, mit der ein Modell Inhalt in einem Vergleichsraum darstellt. Ähnliche Inhalte sollen dort in geeigneter Weise nahe beieinander liegen. Bei einer Darstellung mit einem Vektor wird eine ganze Passage oder ein Dokument in einer solchen Zahlenfolge zusammengeführt. Die Suche vergleicht dann die Frage mit diesen kompakten Repräsentationen.
Das ist für große Sammlungen attraktiv. Pro Passage muss nur eine begrenzte Zahlenmenge gespeichert und verglichen werden. Häufig genügt die Nähe zum Gesamtthema, um gute Kandidaten zu finden. Eine Suche nach „Wartung einer Solaranlage“ kann etwa mehrere allgemein passende Anleitungen zurückgeben, ohne jede einzelne Angabe sofort auseinanderzuhalten.
Schwieriger wird der Fall, wenn eine lange Seite mehrere Gegenstände behandelt. Eine Montageanleitung kann Dach, Garage, Kabelwege und Versicherung zugleich erwähnen. Die Gesamtbeschreibung der Seite verdichtet diese verschiedenen Details. Wie gut ein seltener Teilaspekt erhalten bleibt, hängt vom Modell und von der Aufteilung in Passagen ab. Kurze Abschnitte können die Aufgabe bereits vereinfachen; viele Vektoren sind eine weitere Möglichkeit.
MaxSim sucht den besten Partner für jedes Frage-Token
Die Grundidee geht auf ColBERT von Khattab und Zaharia zurück. Frage und Dokument werden unabhängig kodiert. Danach vergleicht das System ihre einzelnen Token-Vektoren. Ein Token ist ein verarbeitetes Textstück; es muss nicht einem vollständigen deutschen Wort entsprechen. Die Vektoren berücksichtigen den Zusammenhang, in dem das Textstück vorkommt.
Beim sogenannten MaxSim-Verfahren sucht jedes Frage-Token seinen ähnlichsten Partner im Dokument. Die höchsten Ähnlichkeitswerte werden anschließend addiert. So kann eine Passage für unterschiedliche Teile der Frage an unterschiedlichen Stellen punkten. Die späte Zusammenführung heißt „Late Interaction“: Die aufwendige Dokumentkodierung kann vorab erfolgen, der feinere Abgleich folgt zur Suchzeit.
Ein frei erfundenes Zahlenbeispiel zeigt die Rechnung. Eine Frage habe zwei relevante Token. Dokument A erreiche für deren jeweils besten Partner 0,8 und 0,7. Seine Summe beträgt 1,5. Dokument B komme auf 0,95 und 0,2, zusammen 1,15. A liegt vorn, obwohl B bei einem Teil der Frage stärker ist. Die Werte dienen ausschließlich der Erklärung; sie stammen aus keinem Modelltest.
Die Summe ist ein Rankingwert, keine Wahrscheinlichkeit für eine richtige Antwort. Außerdem wächst die mögliche Summe mit der Zahl der Frage-Token. Die Sentence-Transformers-Dokumentation unterscheidet deshalb MaxSim und MeanMaxSim, bei dem durch die Zahl der Frage-Token geteilt wird. Eine Zahl ohne Kenntnis der verwendeten Bewertungsfunktion lässt sich kaum sinnvoll vergleichen.
Wo der Speicherbedarf entsteht
Der Detailgewinn hat einen greifbaren Aufwand. Angenommen, ein Dokument erhält tausend Token-Vektoren mit jeweils 128 Zahlen. Speichert man jede Zahl mit vier Bytes, ergeben sich 512.000 Bytes reine Vektordaten. Für eine Million solcher Dokumente wären es 512 Gigabyte in dezimaler Rechnung. Zusätzliche Indexstrukturen, Metadaten und Kopien sind darin noch nicht enthalten.
Zum Vergleich: Ein einzelner Vektor mit denselben 128 Dimensionen und derselben Zahlendarstellung benötigt 512 Bytes. Das Verhältnis beträgt unter diesen bewusst gleichen Annahmen tausend zu eins. Es beschreibt ein Rechenbeispiel, keinen gemessenen Perplexity-Index. Tatsächliche Modelle unterscheiden sich in Vektorlänge, Tokenzahl, Datentyp und Kompression. Der Vergleich isoliert hier den Effekt der Anzahl gespeicherter Vektoren.
Mehr Dokumente oder längere Seiten erhöhen die Datenmenge entsprechend. Bei visuellen Dokumenten hängt der Aufwand zudem davon ab, wie die Bilddarstellung in verarbeitete Elemente zerlegt wird. Deshalb reicht die Zahl der PDF-Dateien als Kapazitätsangabe kaum aus. Ein kurzer Brief und eine umfangreiche bebilderte Anleitung können den Index sehr unterschiedlich belasten.
Bereits ColBERTv2 beschäftigte sich mit diesem Zielkonflikt. Das Paper kombiniert späten Detailabgleich mit Kompression und berichtet in seinen Versuchen deutlich kleinere Repräsentationen. Diese Ergebnisse zeigen eine technische Möglichkeit; ihre damaligen Einsparfaktoren lassen sich nicht als gemessener Wert der neuen Perplexity-Modelle übernehmen.
Ein größerer Index kann auch zur Suchzeit kosten
Vorberechnung verschiebt Arbeit nach vorn. Neue oder veränderte Dokumente müssen zunächst kodiert werden. Zur Abfrage muss das System geeignete Kandidaten finden und deren Detailvektoren vergleichen. Wie viel davon schnell zugänglich ist, hängt unter anderem von Speicher, Indexaufbau und Suchverfahren ab. Ein kleinerer Frage-Encoder kann einen Teil der laufenden Arbeit reduzieren, während der große Dokumentindex bestehen bleibt.
In der Praxis muss daher die gesamte Kette betrachtet werden: Sammlung aufbereiten, Index erzeugen, Änderungen einarbeiten, Kandidaten suchen und Ergebnisse bewerten. Eine schnell berechnete Frage garantiert allein keine kurze Antwortzeit. Auch eine passende Passage muss für die anschließende Antwort noch korrekt ausgewertet werden.
Die Sentence-Transformers-Beispiele zeigen mit Token-Pooling eine weitere Stellschraube. Dabei werden Dokumentvektoren gruppiert und zusammengefasst. Die Dokumentation vergleicht die Verringerung der Tokenzahl mit Veränderungen des MaxSim-Werts. Das macht den Kompromiss sichtbar: Weniger Repräsentationen sparen Platz, können aber den feinen Abgleich verändern.
Ein weiterer Vergleich betrifft die Aufteilung des Ausgangsmaterials. Statt eine ganze Anleitung als Einheit zu speichern, kann eine Anwendung kleinere Abschnitte anbieten. Dadurch erhalten seltene Details bei einer Einvektorsuche mehr Gewicht. Zugleich kann ein Abschnitt den Zusammenhang zu einer Einschränkung auf der nächsten Seite verlieren. Die sinnvolle Einheit ist daher Teil der Sucharchitektur. Mehrvektorvergleich und gute Dokumentaufbereitung ergänzen einander.
Auch die Ergebnisdarstellung beeinflusst den praktischen Nutzen. Eine gefundene Seite sollte zur gesuchten Angabe zurückführen, damit der Leser Überschrift, Einheit und Fußnote gemeinsam prüfen kann. Liefert eine Anwendung nur eine zusammengefasste Antwort, bleibt der genaue Ursprung schwerer nachvollziehbar. Das gilt bei beiden Vektormethoden und folgt aus ihrer Rolle als Suchverfahren.
Wann die Methode einen Vorteil erwarten lässt
Ein plausibler Einsatzfall sind Dokumente, in denen mehrere kurze Details für die Frage gemeinsam wichtig sind. Dazu gehören technische Unterlagen mit Tabellen, Bildbeschriftungen oder wechselnden Themen. Eine visuelle Repräsentation kann außerdem Informationen erhalten, die bei einer reinen Textaufbereitung anders oder unvollständig vorliegen. Ob das tatsächlich hilft, muss am eigenen Material geprüft werden.
Gegenfälle sind ebenso wichtig. Für kurze, klar abgegrenzte Passagen kann ein einzelner Vektor bereits ausreichend sein. Bei einer Suche nach einer exakten Teilenummer ist ein wortbasierter Treffer oft ein sinnvoller Vergleich. Enthält das Dokument eine Verneinung wie „nicht für Garagen geeignet“, können passende Begriffe trotzdem hohe lokale Ähnlichkeiten liefern. Der Rang allein entscheidet daher nicht, ob die Aussage die Frage inhaltlich beantwortet.
Eine aussagekräftige Bewertung verbindet bekannte Fragen mit überprüften Zielstellen und Gegenbeispielen. Neben der Trefferqualität zählen Indexgröße, Aktualisierungsaufwand und Antwortzeit. Daraus folgt eine konkrete Entscheidung: Viele Vektoren lohnen sich dort, wo ihre zusätzlichen lokalen Vergleiche einen nachweisbaren Nutzen bringen. Das neue Modellangebot erweitert die Auswahl, während die passende Methode weiterhin vom Dokumentbestand abhängt.
Quellen
- Perplexity: pplx-embed-v2-late-9b model card (2026-10-07).
- Khattab / Zaharia: ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction (2020-04-27).
- Santhanam et al.: ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction (2021-12-02).
- Sentence Transformers: Applications – MultiVectorEncoder, retrieval and compression; Abruf 11.10.2026.
- Sentence Transformers: Similarity metrics – MaxSim and MeanMaxSim; Abruf 11.10.2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.