Wie viel Strom KI künftig benötigt, scheint sich auf eine einzige große Zahl reduzieren zu lassen. In Wirklichkeit steckt hinter einer solchen Zahl eine Kette von Annahmen: wie viele Rechner gebaut werden, welche Chips darin arbeiten, wie lange sie genutzt werden und wie viel Energie der Betrieb tatsächlich braucht. Eine Änderung an einer dieser Stellen kann die Prognose verschieben, bevor überhaupt ein zusätzlicher Stromzähler installiert ist.
Das im Juni 2026 veröffentlichte LBNL-Update trägt den Titel „2025 Update“. Es zeigt für US-Rechenzentren bis 2030 verschiedene Ergebnisse unter unterschiedlichen Annahmen. Zusammen mit dem Bericht von 2024 und der IEA-Analyse von 2025 entsteht ein Bild fortlaufender Modellarbeit. Die entscheidende Entwicklung ist daher nicht eine unaufhaltsam wachsende Einzelzahl, sondern die sichtbarere Frage, welche technische Zukunft mit ihr gerechnet wird.
Ein Stromzähler und ein Zukunftsmodell tun Verschiedenes
Ein Zähler erfasst Energie an einem konkreten Anschluss während eines bestimmten Zeitraums. Ein Modell für 2030 muss dagegen Infrastruktur berücksichtigen, die heute teilweise noch nicht existiert. Es verbindet vorhandene Informationen mit Erwartungen über Ausbau und Nutzung. Die zusätzliche Unsicherheit ist eine Eigenschaft der Aufgabe, kein Hinweis darauf, dass Stromverbrauch grundsätzlich nicht messbar wäre.
Schon der Gegenstand muss klar sein. Eine Zahl für sämtliche Rechenzentren umfasst mehr als KI-Anwendungen. Eine globale Prognose beschreibt eine andere Region als eine Rechnung nur für die USA. Und eine jährliche Energiemenge ist etwas anderes als die benötigte elektrische Leistung zu einem bestimmten Zeitpunkt. Werden diese Grenzen vermischt, können zwei seriöse Zahlen fälschlich wie ein Widerspruch erscheinen.
Der LBNL-Bericht von 2024 dokumentiert eine frühere Fassung der US-Modellierung. Ein späteres Update kann neue Informationen und einen anderen Zeithorizont berücksichtigen. Wer Ergebnisse vergleicht, muss deshalb zuerst Region, Zieljahr und enthaltene Technik abgleichen. Eine frühere Zahl für 2028 und eine spätere Zahl für 2030 sind noch kein Beleg für eine bestimmte Prognosekorrektur.
Vom Chipbestand zur jährlichen Energiemenge
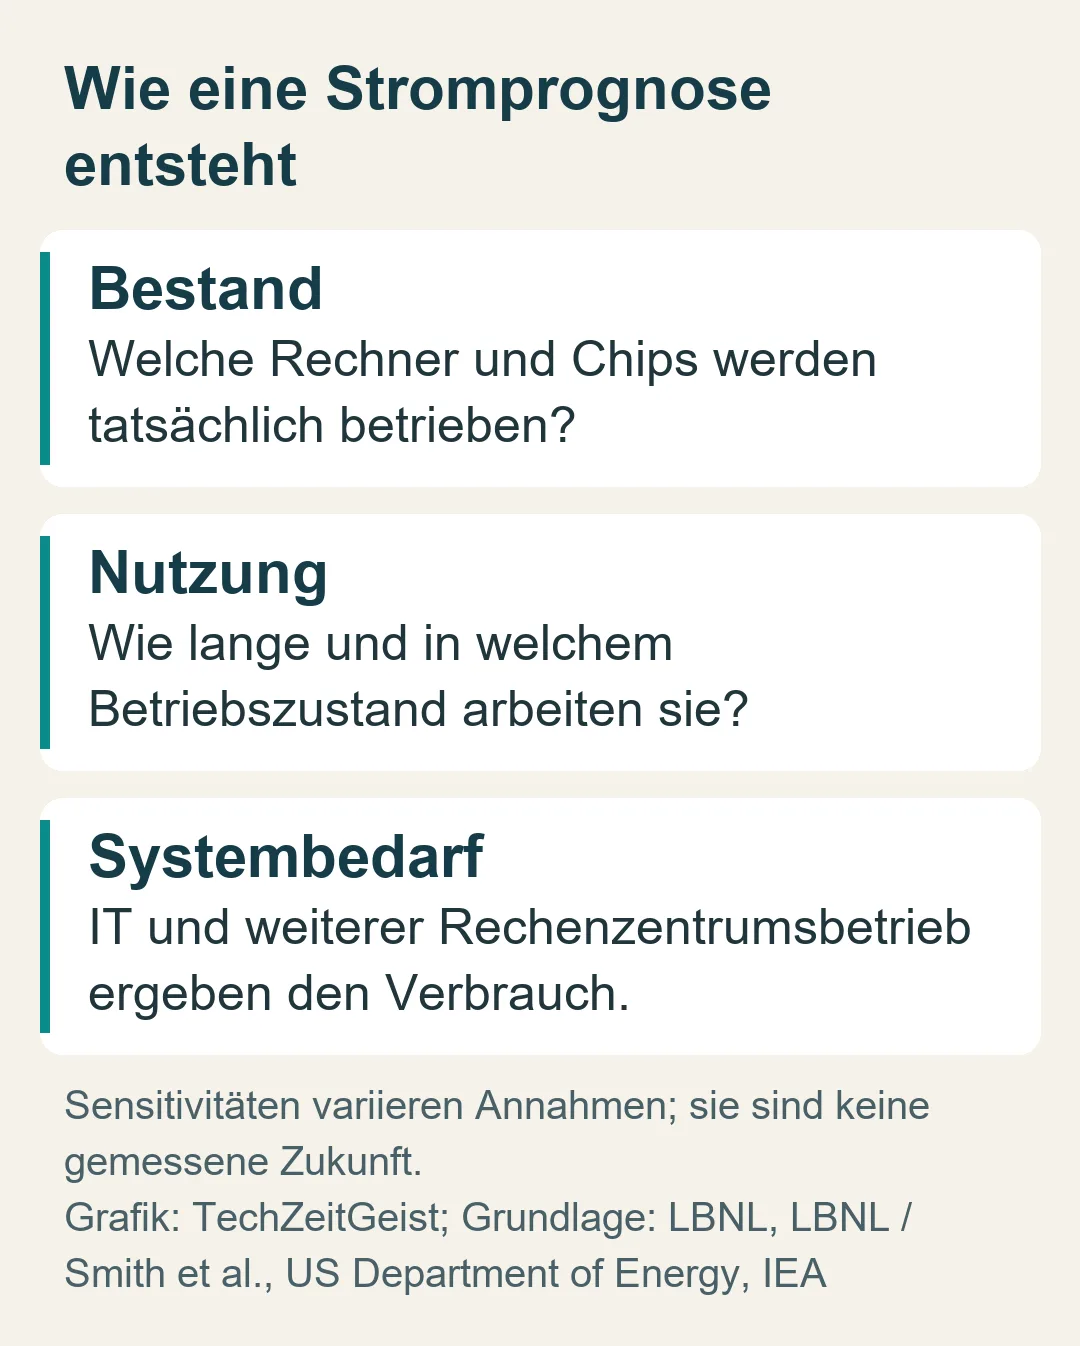
Ein vereinfachtes Gedankenmodell beginnt bei der Anzahl und Art der vorhandenen Rechner. Danach fragt es, wie lange sie betrieben werden und welche Leistung sie dabei tatsächlich aufnehmen. Zur IT kommen weitere Teile des Rechenzentrumsbetriebs. Das ist kein vollständiges Rechenmodell, macht aber verständlich, an wie vielen Stellen eine Erwartung einfließt.
Die Zahl der ausgelieferten Chips allein reicht nicht. Ein Gerät kann installiert werden, eine ältere Einheit ersetzen, nur zeitweise arbeiten oder in einer anderen Betriebsweise genutzt werden als erwartet. Auch die Lebensdauer beeinflusst den Bestand: Werden ältere Geräte länger behalten, sieht die Summe aller aktiven Systeme anders aus als bei einem schnellen Austausch.
Ebenso wenig ist eine angegebene Nenn- oder Auslegungsleistung automatisch die ständig gemessene Leistungsaufnahme. Betrieb unter Last und Leerlauf unterscheiden sich. Aus halbierter Auslastung folgt auch nicht zwingend halbierter Verbrauch, weil ein System weiterhin eine Grundlast haben kann. Deshalb braucht eine Prognose Annahmen über den Betriebszustand und nicht bloß die Addition von Prospektwerten.
Ein bewusst erfundenes Beispiel zeigt den Unterschied: Zwei gleich große Rechnerbestände könnten dieselbe Zahl von Aufträgen bearbeiten, wenn einer effizienter rechnet oder anders ausgelastet ist. Wird die schnellere Bearbeitung anschließend für zusätzliche Aufträge genutzt, kann der Vorteil pro Aufgabe bestehen bleiben, während der Gesamtverbrauch wächst. Welche Reaktion tatsächlich eintritt, muss beobachtet werden; sie ist nicht durch das Wort Effizienz entschieden.
Ein Bereich beschreibt hier Annahmen, keine Wahrscheinlichkeit
Das LBNL-Update nennt für 2030 im Referenzfall649 Terawattstunden Stromverbrauch der US-Rechenzentren. Kombinierte Extremannahmen ergeben einen Bereich von521 bis 843 Terawattstunden. Der Bereich ist kein statistisches Konfidenzintervall. Er zeigt, wie weit die Rechnung unter bestimmten Kombinationen gesetzter Voraussetzungen auseinanderlaufen kann.
Diese Unterscheidung verändert die Lesart erheblich. Ein Wahrscheinlichkeitsintervall würde eine Aussage darüber erlauben, mit welcher modellierten Wahrscheinlichkeit ein Wert in einem Bereich liegt. Eine Sensitivitätsrechnung untersucht dagegen, was passiert, wenn ausgewählte Annahmen anders gesetzt werden. Die äußersten Kombinationen sind nicht automatisch gleich wahrscheinlich oder ein vollständiger Katalog aller denkbaren Entwicklungen.
Man kann Sensitivitäten daher wie Fragen an das Modell lesen: Was ändert sich bei anderen Hardwareentscheidungen? Wie wirkt eine andere Nutzung? Welche Voraussetzung bewegt das Ergebnis besonders stark? Der Erkenntnisgewinn liegt dann darin, die wichtigen Unsicherheiten zu finden. Ein Endwert ohne diese Fragen wäre für die Planung deutlich weniger hilfreich.
Der Data Center Resource Hub des US-Energieministeriums stellt solche Modellarbeit in den Zusammenhang von Energieversorgung und Rechenzentren. Auch hier bleibt eine Verbrauchsprojektion von einer Zusage neuer Erzeugung oder Netzkapazität zu unterscheiden. Dass ein Modell eine bestimmte Nachfrage beschreibt, beweist noch nicht, dass die nötige Versorgung rechtzeitig an jedem gewünschten Ort bereitsteht.
Warum sich eine globale Zahl nicht einfach übertragen lässt
Die IEA betrachtet in Energy demand from AI weltweite Rechenzentren und unterschiedliche Entwicklungsszenarien. Regionale Unterschiede und die Einführung verschiedener Technologien gehören damit zum Bild. Eine solche globale Rechnung kann die US-Analyse ergänzen, ohne denselben Zahlenwert liefern zu müssen. Beide müssten erst auf dieselbe Abgrenzung gebracht werden, bevor ihre Ergebnisse direkt vergleichbar wären.
Ein weiterer Unterschied liegt zwischen Energieverbrauch und Energieerzeugung für diesen Verbrauch. Die IEA erklärt in Energy supply for AI, dass ihre Versorgungsanalyse den physisch genutzten Strommix betrachtet. Vertraglich ausgewiesene Beschaffung und physische Versorgung sind daher nicht beliebig austauschbare Angaben. Wer zusätzlich Klimawirkungen diskutiert, braucht diese zweite Ebene der Rechnung.
Diese Trennungen verhindern eine verbreitete Abkürzung: Eine große Rechenzentrumszahl wird genommen, als ausschließlich KI-Verbrauch bezeichnet und anschließend ungeprüft auf ein anderes Land übertragen. Dabei ändern sich Gegenstand und Region, ohne dass die Modellannahmen mitwandern. Der Fehler liegt dann bereits vor der Diskussion darüber, ob die Zahl zu hoch oder zu niedrig erscheint.
Für die Bewertung eines Updates ist somit nicht nur der Zeitpunkt der Veröffentlichung wichtig. Ebenso zählt, welche neuen Informationen tatsächlich eingeflossen sind. Ein moderneres Datum allein garantiert weder bessere Hardwaredaten noch eine passendere Abgrenzung für die eigene Frage.
Was eine gute Planung aus Unsicherheit macht
Planung kann mit Unsicherheit umgehen, wenn sie deren Ursachen offenlegt. Besonders wertvoll sind Szenarien, die zeigen, welche Entscheidungen unter mehreren plausiblen Entwicklungen noch funktionieren. Das ist eine andere Aufgabe als die Suche nach einer einzigen Zahl, die jede weitere Debatte beendet.
Technischer Fortschritt liefert dabei ein wichtiges Gegenargument gegen einfache Wachstumslinien. Ein effizienterer Chip kann weniger Energie pro Aufgabe benötigen. Gleichzeitig können mehr Nutzer, neue Anwendungen oder zusätzliche Aufgaben den Gesamteffekt verändern. Aus den hier gelesenen Quellen folgt weder, dass Effizienz den Bedarf sicher stabilisiert, noch dass sie durch zusätzliche Nachfrage zwangsläufig vollständig aufgezehrt wird.
Welche Entwicklung eintritt, lässt sich mit besser dokumentierten Beständen, realen Betriebsdaten und genauerer Zuordnung von Anwendungen prüfen. Ein gutes Modell macht sichtbar, welche dieser Informationen besonders fehlen. Dann kann ein späteres Update erklären, warum ein Ergebnis anders ausfällt, statt nur eine neue große Zahl in die Öffentlichkeit zu stellen.
Die drei zeitlich getrennten Berichte zeigen deshalb mehr als steigende Aufmerksamkeit für KI. LBNL und IEA arbeiten an unterschiedlichen, ausdrücklich begrenzten Rechnungen; die beiden LBNL-Fassungen sind dabei dieselbe institutionelle Linie. Zusammen tragen sie die These, dass Hardware- und Nutzungsannahmen zum Kern der Energiedebatte gehören. Wer eine Prognose verstehen will, sollte genau dort beginnen: bei der technischen Zukunft, die das Modell voraussetzt.
Quellen
- LBNL: 2024 United States Data Center Energy Usage Report (2024)
- LBNL / Smith et al.: United States Data Center Energy Usage Report: 2025 Update (2026-06)
- US Department of Energy: Powering America’s AI Future—Data Center Resource Hub
- IEA: Energy demand from AI (2025)
- IEA: Energy supply for AI (2025)
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.