65 Prozent niedrigere geschätzte tägliche KI-Kosten klingen wie ein klarer Erfolg. Der neue Fallbericht über LegalOn beschreibt jedoch ein Bündel von Änderungen: Aufgaben werden auf unterschiedliche Modelle verteilt, schnelle Ausführung wird gezielter eingesetzt, und Budgets folgen unterschiedlichen Geschäftsanforderungen. Wer daraus eine universelle Sparquote für Modellrouting ableitet, übersieht die Vergleichsbasis und mehrere gleichzeitig veränderte Regeln.
Die für Unternehmen wichtigere Frage lautet: Wie viel kostet eine brauchbar abgeschlossene Aufgabe? Eine niedrigere Rechnung für KI-Nutzung kann hilfreich sein. Sie erklärt aber noch nicht, ob weniger Arbeit anfiel, ob Aufgaben anders gelöst wurden oder ob Menschen anschließend mehr korrigieren mussten. Der LegalOn-Fall eignet sich deshalb vor allem dazu, diese Unterschiede sichtbar zu machen.
Die gemeldeten Prozentwerte meinen Verschiedenes
Im von OpenAI veröffentlichten Bericht nennt LegalOn eine Senkung der geschätzten täglichen Kosten um 65 Prozent gegenüber einer Basis mit GPT-5.5 Fast. Daneben wird eine Kostenverbesserung von 20 Prozent für reife Geschäftsbereiche beschrieben. Das sind unterschiedliche Kennzahlen mit unterschiedlichem Bezug. Sie sollten weder addiert noch als zwei Messungen derselben Wirkung behandelt werden.
Zum Maßnahmenpaket gehören Modellwahl nach Aufgabe, Regeln für schnelle Ausführung und differenzierte Budgets. Eine Messung des wirtschaftlichen Nutzens bis zur veröffentlichten Funktion wird laut Bericht erst aufgebaut. Die Angaben sind damit eine zugeschriebene Unternehmensdarstellung; ein isolierter Nachweis, dass Routing allein 65 Prozent spart, liegt nicht vor.
Routing braucht eine begründete Aufgabenaufteilung
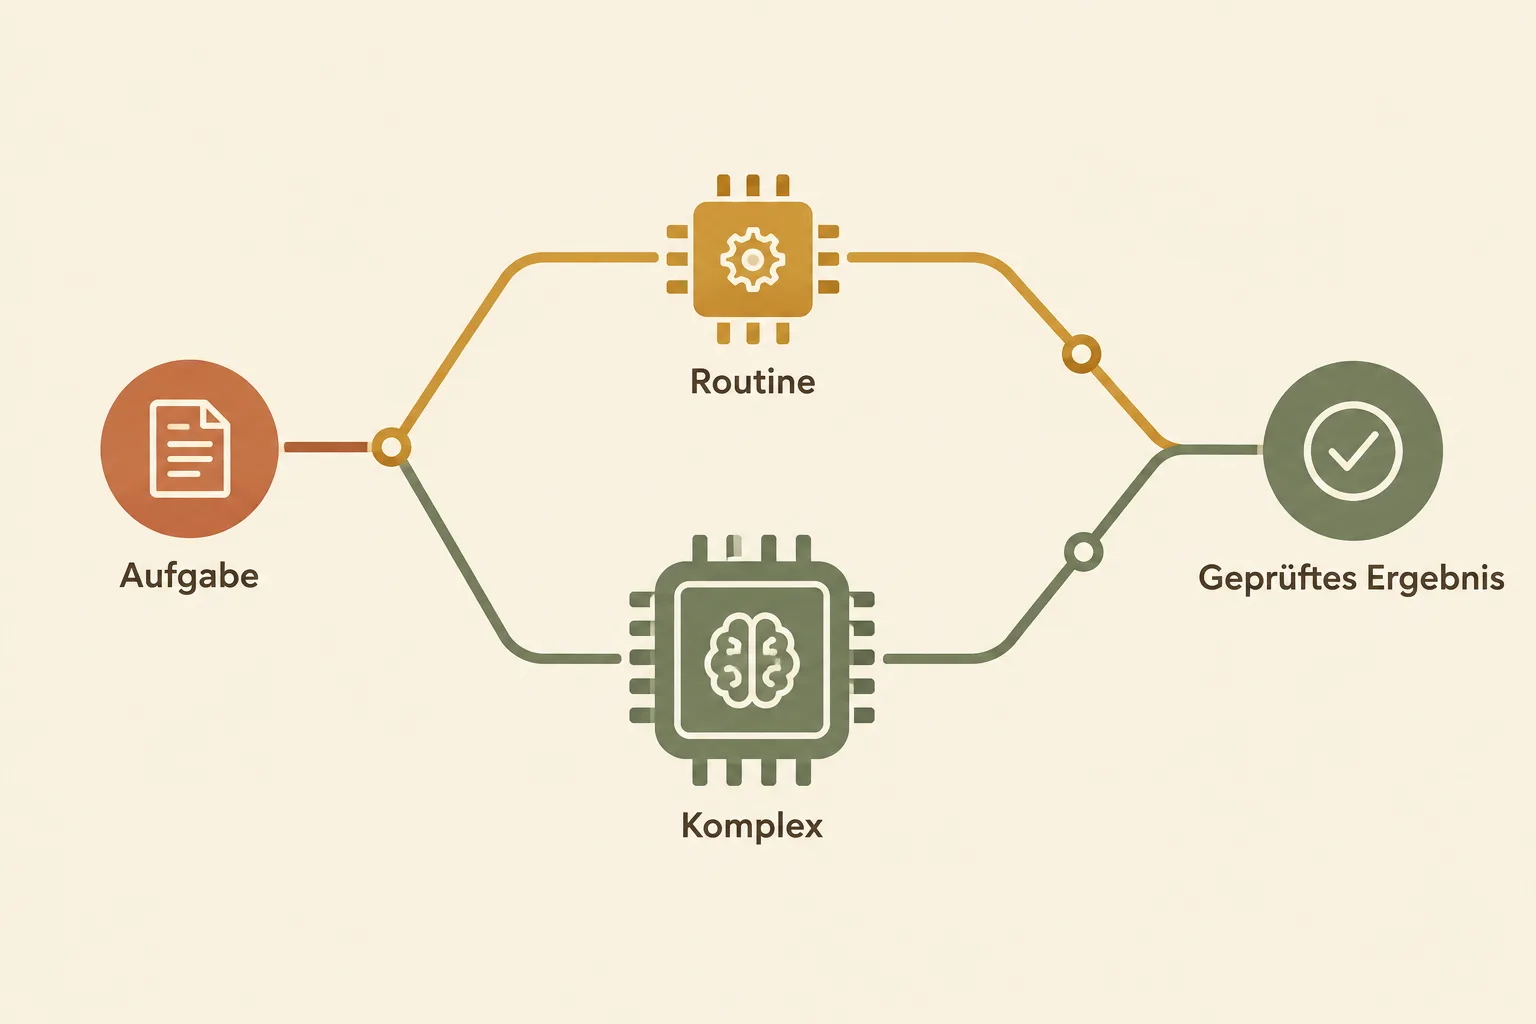
Der Grundgedanke lässt sich ohne Produktnamen erklären. Ein Team hat wiederkehrende, gut beschriebene Aufgaben und andere, bei denen Architekturentscheidungen oder unklare Anforderungen geklärt werden müssen. Es kann für die erste Gruppe einen günstigeren Ablauf wählen und für die zweite mehr Ressourcen einsetzen. Das ist nur dann sinnvoll, wenn die fertigen Ergebnisse den jeweiligen Anforderungen genügen.
Entscheidend ist deshalb nicht allein, wie eine Aufgabe vor dem Start bezeichnet wird. Eine zunächst einfache Änderung kann sich als schwierig erweisen, weil sie mit bestehenden Funktionen zusammenhängt. Das Routing muss mit solchen Fällen umgehen können. Sonst spart das Team beim ersten Versuch und bezahlt die vermeintliche Ersparnis später mit Wiederholungen oder zusätzlicher menschlicher Arbeit.
Ein billiger Versuch kann ein teures Ergebnis ergeben
Ein frei erfundenes Rechenbeispiel zeigt den Unterschied. Modell A kostet pro Versuch eine Recheneinheit und liefert bei der betrachteten Aufgabengruppe in der Hälfte der Fälle ein brauchbares Ergebnis. Modell B kostet zwei Einheiten und erreicht in neun von zehn Fällen das gewünschte Ergebnis. Diese Zahlen sind keine Preise oder Leistungswerte realer Modelle und keine Daten von LegalOn.
Wenn man stark vereinfacht unabhängige Versuche bis zum Erfolg wiederholt, liegt der erwartete reine Modellaufwand bei A bei zwei Einheiten: eins geteilt durch 0,5. Bei B sind es rund 2,22 Einheiten: zwei geteilt durch 0,9. Der große Preisunterschied pro Aufruf schrumpft also bereits, bevor menschliche Nacharbeit berücksichtigt wird.
Nun nehmen wir zusätzlich an, jeder fehlgeschlagene Versuch verursacht eine Einheit Prüf- und Korrekturaufwand. Im selben vereinfachten Modell ergibt sich bei A insgesamt ein erwarteter Aufwand von drei Einheiten, bei B rund 2,33. Die Reihenfolge dreht sich um. Das Beispiel beweist nichts über konkrete Produkte. Es macht sichtbar, welche Kosten eine reine Aufrufstatistik auslassen kann.
In der Praxis sind Wiederholungen nicht beliebig unabhängig, und ein zweiter Versuch kann anderen Kontext erhalten. Genau deshalb sollte ein Team die Kosten der gesamten Aufgabe beobachten, statt das Beispiel als fertige Kalkulationsformel zu übernehmen. Seine nützliche Aussage ist die Verbindung von Preis, Erfolgswahrscheinlichkeit und Nacharbeit.
Auch eingesparte Zeit braucht eine passende Messung
Eine unabhängige Untersuchung von METR zeigte 2025, dass erfahrene Entwickler in einem begrenzten Open-Source-Experiment mit damaligen KI-Werkzeugen 19 Prozent länger benötigten. Das Ergebnis galt für dieses Setting, nicht für jede Softwarearbeit. Es mahnt zur Vorsicht, wenn gefühlte Beschleunigung als gemessene Zeitersparnis ausgegeben wird.
Der Stand blieb allerdings nicht dort stehen. Im Update vom Februar 2026 berichtete METR über Anzeichen einer höheren Beschleunigung und zugleich deutliche Auswahl- und Messprobleme. Die neueren Daten lieferten nach eigener Einschätzung keinen verlässlichen aktuellen Effekt. Diese Entwicklung verhindert sowohl ein pauschales Sparversprechen als auch die Behauptung, KI verlangsame Entwickler grundsätzlich.
Für den LegalOn-Bericht bedeutet das: Niedrigere Nutzungsaufwendungen und höhere Arbeitsproduktivität sind zwei getrennte Fragen. Sie können zusammen auftreten, müssen es aber nicht. Um beide zu verbinden, braucht es vergleichbare Aufgaben und ein nachvollziehbares Verständnis davon, wann eine Aufgabe tatsächlich abgeschlossen ist.
Budgets verändern Verhalten und Vergleichsbasis
Ein Budget ist mehr als eine andere Modellwahl. Es kann beeinflussen, welche Aufgaben ein Team an die KI delegiert, wie oft es erneut fragt und wann es auf einen anderen Ablauf ausweicht. Sinkt nach einer Budgetänderung die tägliche Rechnung, könnte das sowohl effizientere Nutzung als auch geringere Nutzung ausdrücken. Ohne Informationen zum Arbeitsumfang lässt sich das nicht auseinanderhalten.
Das Gleiche gilt für unterschiedlich behandelte Geschäftsbereiche. Ein etabliertes Produkt mit wiederkehrender Arbeit kann andere Anforderungen haben als ein neues Vorhaben, in dem viel erkundet wird. Einheitliche Sparvorgaben könnten diese Unterschiede verdecken. Der Fallbericht macht deshalb die organisatorische Seite der KI-Kosten sichtbar, ohne deren Wirkung für andere Unternehmen bereits zu beziffern.
Ein Wechsel sollte dieselbe Aufgabe beantworten
Ein weiterer eigener Vergleich verdeutlicht die Messfrage. Ein Team lässt mit Ablauf A eine Änderung inklusive Dokumentation erstellen. Ablauf B erzeugt nur den Codeentwurf. Wenn B weniger Ressourcen verbraucht, könnte das an der geringeren Aufgabe liegen. Ein fairer Vergleich müsste klären, wie viel zusätzliche Arbeit benötigt wird, bis beide denselben akzeptierten Stand erreichen.
Das gilt auch für unterschiedlich strenge Ergebnisanforderungen. Wird beim günstigeren Ablauf mehr Fehlerkorrektur akzeptiert oder später erledigt, wandert Aufwand zwischen den Beteiligten. Die Modellrechnung sieht dann besser aus, während die gesamte Aufgabe nicht entsprechend günstiger geworden sein muss. Umgekehrt kann ein bewusst einfacher Entwurf vollkommen passend sein, wenn genau dieser beauftragt war.
Die hilfreiche Entscheidung lautet deshalb nicht, immer das aufwendigste Verfahren zu wählen. Sie lautet, das Ergebnis ausreichend genau zu definieren. Ein Wegwerfprototyp braucht möglicherweise etwas anderes als eine Änderung an einem regelmäßig genutzten Produkt. Werden solche Aufgaben zusammengeworfen, verdeckt eine einzige Durchschnittsquote den tatsächlichen Nutzen der Ressourcenverteilung.
In dieser Betrachtung wird Routing zu einer überprüfbaren Arbeitsentscheidung. Jede Aufgabengruppe erhält eine nachvollziehbare Anforderung, und der Vergleich betrachtet den Aufwand bis dorthin. Das ist die praktische Ergänzung zur gemeldeten täglichen Rechnung.
Welche Zahl eine Entscheidung erleichtert
Ein Team könnte zunächst eine klar abgegrenzte Gruppe wiederkehrender Aufgaben betrachten. Für diese Gruppe wären Nutzungsaufwand, menschliche Nacharbeit und akzeptierte Ergebnisse gemeinsam zu erfassen. Ein Vergleich wird verständlicher, wenn die Anforderungen an das Ergebnis gleich bleiben und Änderungen am Arbeitsumfang dokumentiert sind.
Die daraus entstehende Zahl wäre beispielsweise der Aufwand pro akzeptierter Änderung, nicht nur der Aufwand pro Tag. Bei besonders unterschiedlichen Aufgaben kann auch diese Kennzahl zu grob sein. Dann hilft eine Aufteilung nach vergleichbaren Aufgabengruppen mehr als eine große Durchschnittszahl.
LegalOns gemeldete Senkung ist damit ein interessanter Hinweis auf bewusste Steuerung der KI-Nutzung. Übertragbar ist vor allem die Frage hinter dem Maßnahmenpaket: Welche Ressourcen braucht diese konkrete Aufgabe bis zu einem brauchbaren Ergebnis? Die 65-Prozent-Zahl selbst bleibt an die veröffentlichte Vergleichsbasis und die gleichzeitig eingeführten Regeln gebunden.
Quellen
- OpenAI / LegalOn: LegalOn Codex costs (2026-10-08)
- METR: Early-2025 developer productivity study (2025-07-10)
- METR: Changing developer experiment design (2026-02-24)
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.