Ein KI-System kann technisch funktionieren und trotzdem menschliche Entscheidungen verschieben – manchmal in eine problematische Richtung. Hier setzt das EU-geförderte Projekt AIOLIA an: Es übersetzt allgemeine Werte wie Transparenz, Verantwortung und Autonomie in Fragen, die sich vor einem konkreten Einsatz prüfen lassen.
Das Wichtigste in 30 Sekunden
- AIOLIA untersucht sechs Anwendungssituationen, in denen KI Diagnosen, Softwarefreigaben, Sicherheitsarbeit, persönliche Assistenz oder therapeutische Prozesse beeinflusst.
- Die zentrale Prüfung lautet nicht nur, ob ein Modell gute Vorschläge macht. Sie muss auch klären, wer entscheidet, welche Daten betroffen sind und wie Fehler korrigiert werden.
- Die finalen Fallbeschreibungen im Deliverable D3.1 unterscheiden sich an mehreren Stellen von der verständlichen Kurzfassung des aktuellen CORDIS-Beitrags.
- Ethics Readiness und Algorithmic Impact Assessment sind Bewertungs- und Gesprächshilfen, aber kein automatisches EU-AI-Act-Zertifikat.
Sechs Fälle, sechs Spannungen
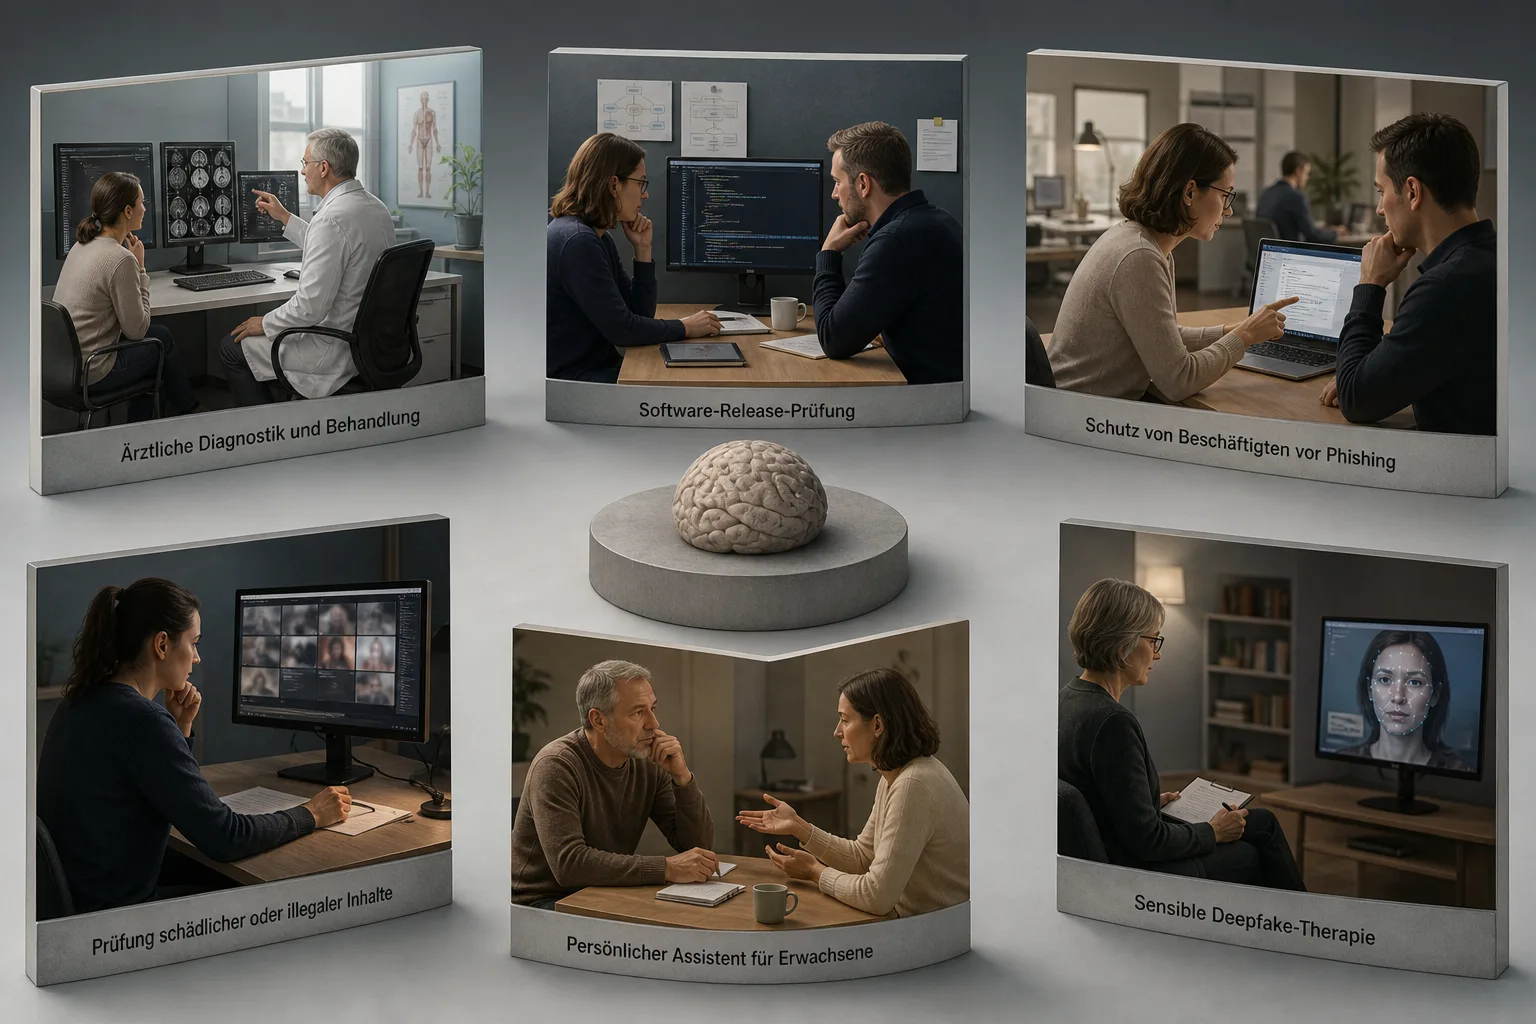
Die Stärke des AIOLIA-Ansatzes liegt im Vergleich. Ein medizinisches System braucht andere Schutzmaßnahmen als eine KI, die Softwarefreigaben beschleunigt. Bei einem persönlichen Assistenten geht es stärker um Autonomie, Privatsphäre und Wohlbefinden; bei sicherheitsbezogenen Anwendungen stehen Rückverfolgbarkeit, Robustheit und klare Zuständigkeiten im Vordergrund.
| Anwendung | Zentrale Spannung | Prüfbare Schutzmaßnahme |
|---|---|---|
| Diagnostik und Behandlung | Wer trägt die Verantwortung, wenn mehrere Beteiligte einem KI-Vorschlag folgen? | Menschliche Freigabe, nachvollziehbare Begründung und ein Weg zur Korrektur. |
| Software-Release-Freigaben | Beschleunigung darf nicht dazu führen, dass Sicherheitsprüfungen nur noch abgenickt werden. | Klare Freigabekriterien, Protokolle und eine benannte verantwortliche Rolle. |
| Schutz vor Cyberangriffen | Eine Bewertung der Verwundbarkeit von Beschäftigten kann hilfreich sein, aber auch in Überwachung kippen. | Zweck, Datenzugriff, Grenzen der Bewertung und Einspruchsmöglichkeiten festlegen. |
| Schädliche oder illegale Inhalte | Erkennung muss Sicherheit erhöhen, ohne legitime Kommunikation pauschal zu unterdrücken. | Kontextprüfung, menschliche Eskalation und dokumentierte Beschwerdewege. |
| Personalisierte Charaktere und Assistenten | Personalisierung kann unterstützen, aber auch Abhängigkeit und Übervertrauen verstärken. | Autonomie, Datenschutz, Transparenz über das System und Grenzen der Einflussnahme prüfen. |
| Deepfake-Therapie | Eine immersive Verarbeitung von Trauma und Trauer berührt besonders sensible Daten und Entscheidungen. | Fachliche Aufsicht, Einwilligung, Sicherheitsgrenzen und ein Abbruch- oder Korrekturweg. |
Die Tabelle beschreibt keine flächendeckende Einführung dieser Systeme. Sie fasst die sechs europäischen Anwendungssituationen zusammen, an denen AIOLIA seine Leitlinien entwickelt. Das öffentliche Deliverable D3.1 präzisiert dabei drei Punkte: Aus dem Recruiting-Beispiel wurde die Bewertung der Verwundbarkeit von Beschäftigten gegenüber Phishing und Cyberangriffen. Aus der Hate-Speech-Kurzfassung wurde ein breiterer Fall zu schädlichen oder illegalen Inhalten. Und beim Assistenten verschob sich der Schwerpunkt vom Familien- zum Erwachsenen-Assistenten.
Wenn Verantwortung verteilt wird
In der Praxis entsteht das größte Risiko oft nicht durch eine einzelne falsche Modellantwort. Problematisch wird es, wenn mehrere Rollen beteiligt sind und am Ende niemand mehr eindeutig zuständig ist. Ein Arzt prüft einen Vorschlag, ein Softwareteam übernimmt eine Freigabe, ein Sicherheitsdienst bewertet Inhalte – überall kann sich menschliche Verantwortung auf eine formale Bestätigung reduzieren.
D3.1 beschreibt diese Gefahr als Übervertrauen und Deskilling: Menschen verlassen sich so stark auf die Maschine, dass sie eigene Fähigkeiten weniger einsetzen oder nur noch passiv bestätigen. Das ist keine reine Modellfrage. Teams müssen festlegen, welche Entscheidung ein Mensch selbst trifft, welche Belege vorliegen müssen und wann ein Vorschlag verworfen wird.
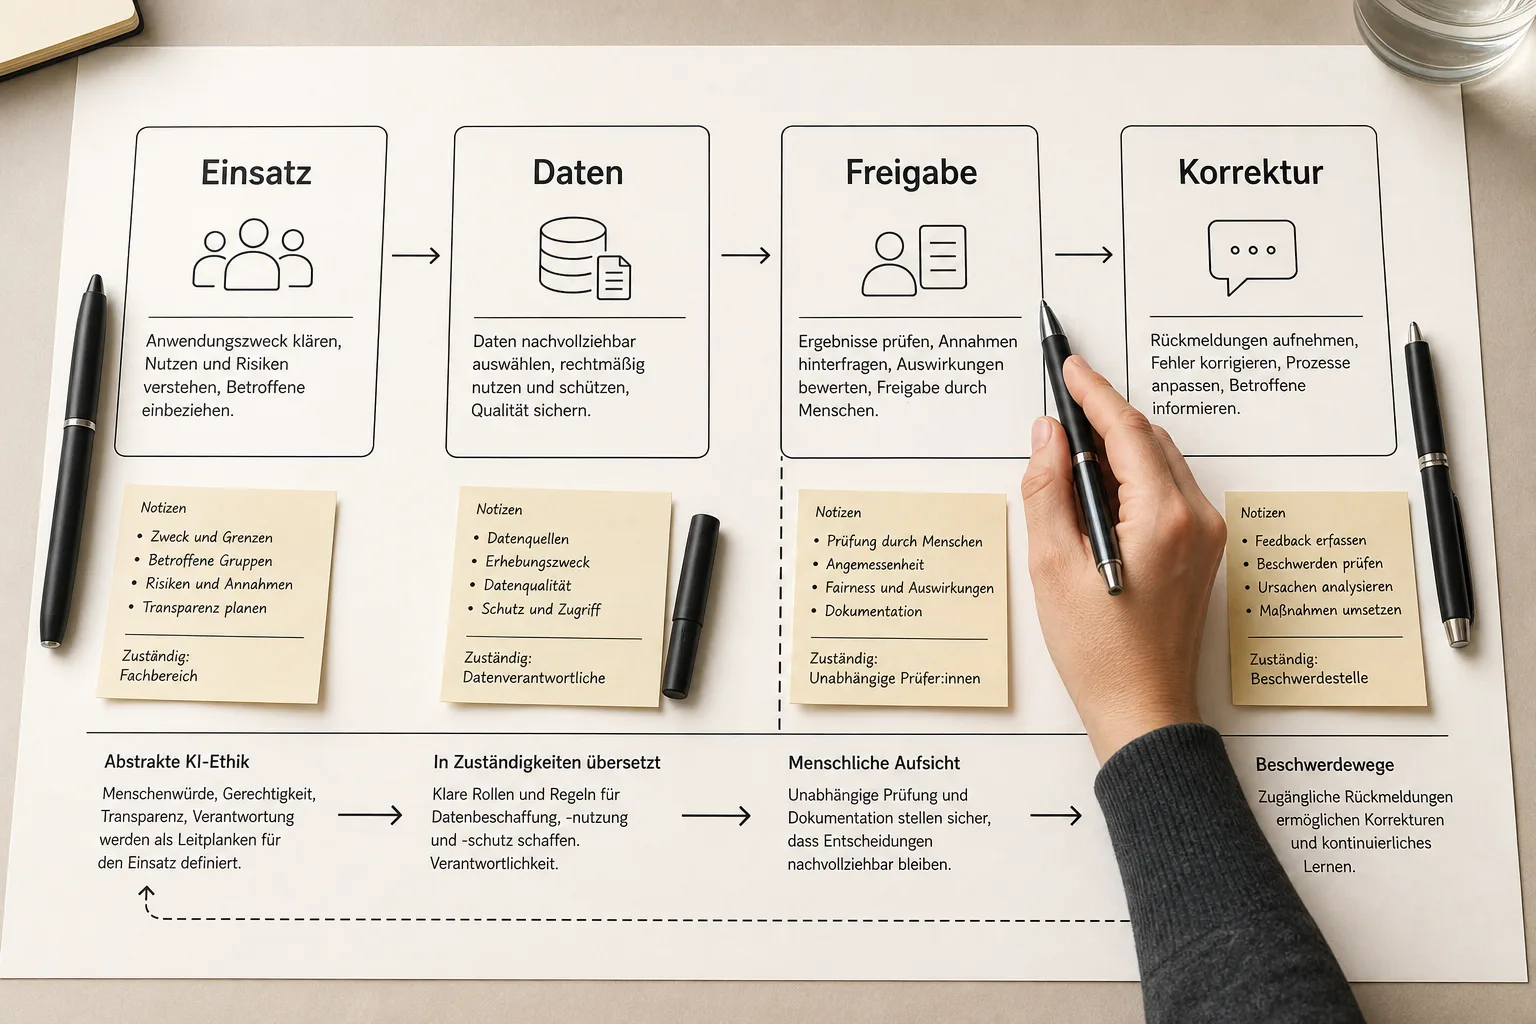
Damit eine Leitlinie im Alltag hilft, braucht sie deshalb mehr als einen Wert wie „Transparenz“. Sie muss in einen Ablauf übersetzt werden: Wer darf das System bedienen? Welche Daten dürfen einfließen? Welche Unsicherheit stoppt den Prozess? Wer prüft die Entscheidung nachträglich? Und wie erfahren Betroffene, dass sie widersprechen können?
Warum private Assistenten anders geprüft werden
Bei persönlichen Assistenten verschiebt sich der Schwerpunkt. Ein System, das Termine ordnet, Gewohnheiten begleitet oder persönliche Entwicklung unterstützt, arbeitet nah an privaten Informationen und beeinflusst möglicherweise Verhalten. Das macht die Frage nach der technischen Genauigkeit allein zu klein.
Ein Beispiel aus dem AIOLIA-Umfeld zeigt die Spannung: Frühere Überlegungen zu einem Familienassistenten berührten zugleich die Privatsphäre von Minderjährigen und das Sicherheitsinteresse der Eltern. Die öffentliche THWS-Darstellung beschreibt, dass der Fokus schließlich stärker auf einen Assistenten für Erwachsene gelegt wurde. Daraus folgt keine allgemeine Lösung für Familienprodukte. Sichtbar wird aber, warum Datenschutz, Schutzinteressen und Autonomie nicht automatisch in dieselbe Richtung weisen.
Für private Systeme sollte eine Prüfung daher auch fragen, ob Nutzerinnen und Nutzer den Einfluss des Assistenten erkennen, Einstellungen selbst ändern und eine Empfehlung zurückweisen können. Ein freundlicher Ton oder eine überzeugende Personalisierung darf nicht darüber hinwegtäuschen, dass das System Ziele verfolgt, Daten verarbeitet und Fehler machen kann.
Readiness ist kein Zertifikat
AIOLIA beschreibt mit Ethics Readiness Levels und Algorithmic Impact Assessment zwei Instrumente, die solche Fragen strukturieren sollen. Das öffentliche Deliverable D3.4 verbindet dafür Indikatoren, dynamische Fragebögen und wiederholte Bewertungen. Der Ansatz setzt auf Dialog: Die Bewertung soll nicht nur einen technischen Zustand ausgeben, sondern unterschiedliche Rollen zusammenbringen.
Der Ansatz ist nützlich, solange der Charakter des Werkzeugs klar bleibt. Ein Readiness-Level beweist nicht, dass ein System sicher arbeitet. Ein Impact Assessment macht ein Produkt nicht automatisch rechtmäßig und ersetzt weder Modelltests noch eine Prüfung nach dem konkreten Einsatz und geltenden Recht. Der Wert liegt darin, blinde Flecken sichtbar zu machen und Entscheidungen zu dokumentieren.
AIOLIA berichtet über einen Rahmen, Trainingsmaterialien und eine methodische Umsetzung. Die Quellen liefern dagegen keinen unabhängigen Nachweis, dass die Leitlinien bereits Diagnosen verbessern, Einstellungen fairer machen, Releases sicherer machen oder das Wohlbefinden von Menschen erhöhen. Diese Grenze ist nicht nebensächlich, sondern gehört zur korrekten Einordnung des Projekts.
Was davon in Deutschland und der EU bleibt
Für Unternehmen, Behörden, Entwickler und medizinische Einrichtungen in Deutschland liegt der praktische Nutzen nicht in einem fertigen Freifahrtschein. AIOLIA liefert eher eine Arbeitsweise: den Einsatz beschreiben, betroffene Personen und Daten erfassen, Zuständigkeiten festlegen, menschliche Eingriffe sichern, Tests und Schulungen dokumentieren und die Folgen regelmäßig neu bewerten.
Das passt zu einer europäischen Debatte, in der nicht nur das Modell, sondern auch sein Einsatzkontext betrachtet wird. Trotzdem darf aus der Projektförderung oder aus dem Instrumentarium keine pauschale Aussage zur Konformität mit dem EU AI Act abgeleitet werden. Ob ein konkretes System zulässig, sicher oder diskriminierungsarm ist, hängt von Zweck, Daten, Risikoklasse, Organisation und Rechtsgrundlage ab.
Die offenen Fragen liegen im Betrieb
Der Ansatz kann zusätzliche Arbeit erzeugen. Teams müssen Rollen definieren, Entscheidungen dokumentieren und Regeln später wieder prüfen. Wenn diese Schritte nur als Formularübung stattfinden, entsteht Bürokratie ohne Schutzwirkung. Wenn sie dagegen mit Freigaben, Training, Beschwerdewegen und technischen Tests verbunden sind, wird aus einem abstrakten Prinzip eine überprüfbare Praxis.
Offen bleibt, wie gut Organisationen solche Verfahren unter Zeitdruck anwenden, wie häufig Bewertungen tatsächlich wiederholt werden und ob Betroffene ihre Rechte verständlich wahrnehmen können. Auch die Frage, welche Messgrößen für Übervertrauen, Kompetenzverlust oder psychische Belastung geeignet sind, ist damit nicht beantwortet.
Fazit: Ethik beginnt vor der Freigabe
AIOLIAs Beitrag ist weniger ein neues Etikett für „ethische KI“ als ein Hinweis auf die richtige Arbeitsebene. Vor dem Einsatz muss klar sein, wer entscheidet, wer eingreifen kann und wer eine Fehlentscheidung korrigiert. Die sechs Fälle zeigen, dass dieselben Werte je nach Anwendung in andere Datenregeln, Freigaben und Schutzmaßnahmen übersetzt werden müssen.
Für die Praxis bleibt deshalb eine einfache, aber anspruchsvolle Frage: Kann eine Organisation nicht nur erklären, warum ein System nützlich sein soll, sondern auch zeigen, wann sie ihm widerspricht?
Quellen und weiterführende Informationen
- Practical ethics for the AI age – CORDIS / Publications Office der Europäischen Union, 18.08.2026.
- OPERATIONALIZING AI ETHICS FOR LEARNING AND PRACTICE: A GLOBAL APPROACH | AIOLIA | Project Fact Sheet – CORDIS / Europäische Kommission.
- Operational ethics guidelines on use cases related to human behaviour and cognition (AIOLIA Deliverable D3.1) – AIOLIA-Konsortium / CENTRIC.
- Mechanism for Evaluating Ethics Readiness Levels and Algorithmic Impact Assessment (AIOLIA Deliverable D3.4) – AIOLIA-Konsortium / RISE.
- European AI ethics in practice: the AIOLIA project at THWS – Technische Hochschule Würzburg-Schweinfurt, 25.06.2026.
Hinweis: Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft. Stand: 2026-08-19